
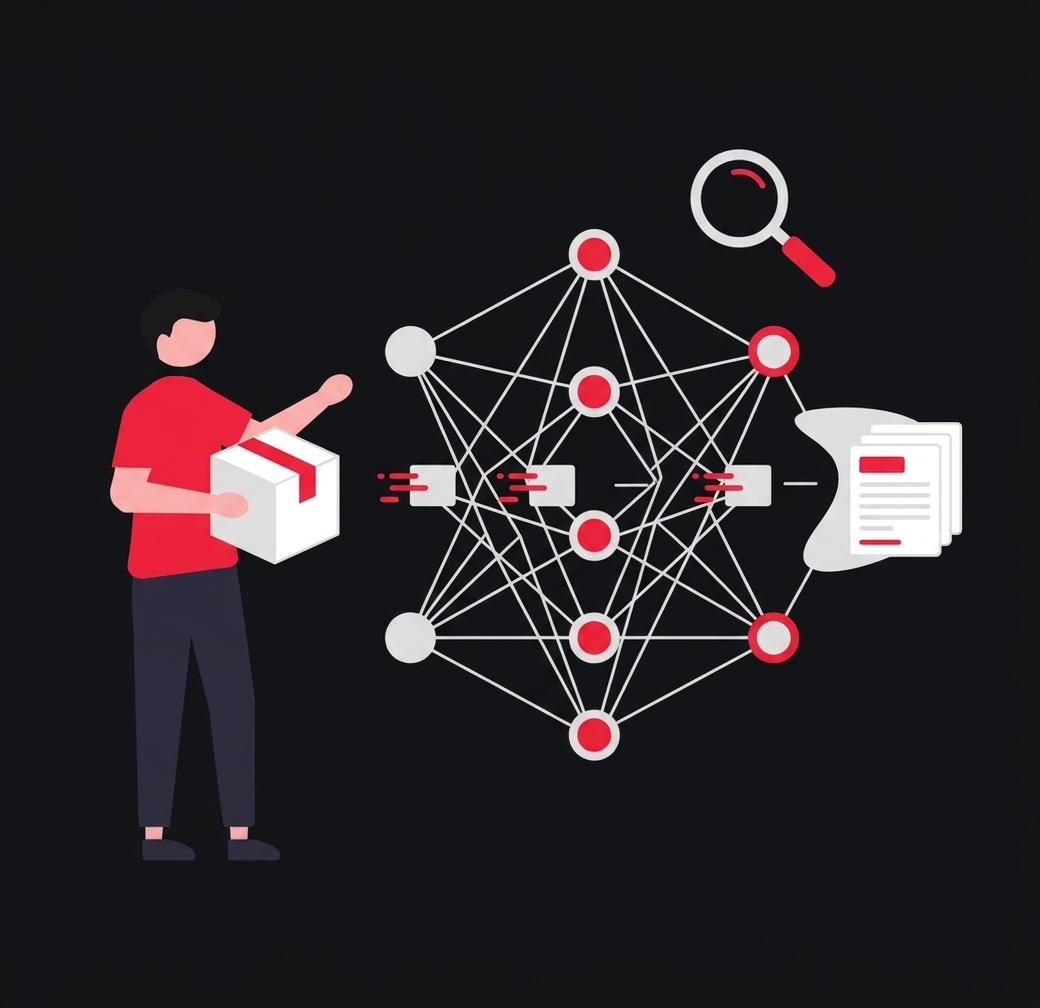
Někdy ta nejlepší vysvětlení fungování technologického řešení pocházejí přímo od softwarových inženýrů, kteří ho vybudovali. Abychom pochopili, jak fungují velké jazykové modely (LLM), obrátili jsme se na tým, který stojí za jejich vývojem a škálováním. Tito inženýři nás provedli procesem, který se skrývá pod kapotou těchto působivých systémů.
Přední výzkumná organizace v oblasti umělé inteligence si klade za cíl bezpečně přinášet pokročilé výzkumné poznatky do světa. V jejím rámci funguje specializovaná skupina, která se od počátku zaměřuje na vytváření a škálování těchto technologií, včetně rozsáhlých jazykových modelů, které jsou dnes běžně dostupné uživatelům i vývojářům.
Když položíte otázku jazykovému modelu, spustí se za kulisami několik klíčových kroků:
1. Vstup: Systém přijme váš text z textového vstupu.
2. Tokenizace: Vstupní text je rozdělen na takzvané „tokeny“. Token zhruba odpovídá několika znakům Unicode a lze si ho představit jako slovo nebo část slova. Je důležité poznamenat, že tokenizace nemusí nutně rozdělovat text na celá slova; tokeny mohou být i jejich podsady.
3. Vytvoření embeddingů: Každý token je následně převeden na vektor čísel, označovaný jako embedding. Embeddingy jsou v srdci velkých jazykových modelů a představují vícerozměrnou reprezentaci tokenu. Modely jsou trénovány tak, aby zachycovaly sémantický význam a vztahy mezi slovy nebo frázemi. Například embeddingy pro slova „pes“ a „štěně“ jsou si v rámci několika dimenzí blíže než embeddingy pro „pes“ a „počítač“. Tyto vícerozměrné reprezentace pomáhají strojům efektivněji rozumět lidské řeči.
4. Násobení embeddingů vahami modelu: Tyto embeddingy jsou poté násobeny obrovským množstvím vah modelu, které čítají stovky miliard. Tato operace je výpočetně velmi náročná. Váhy modelu se používají k výpočtu vážené matice embeddingů, která se pak využívá k předpovědi nejpravděpodobnějšího dalšího tokenu.
5. Vzorkování předpovědi: Po provedení miliard násobení výsledný vektor čísel představuje pravděpodobnost nejpravděpodobnějšího dalšího tokenu. Vzorkování je proces, kdy se vybere tento nejpravděpodobnější token a odešle se zpět uživateli. Každé slovo, které model vygeneruje, je výsledkem tohoto opakovaného procesu, který probíhá mnohokrát za sekundu.
Chystáte nový web nebo aplikaci?
Napište mi, co plánujete — rád se na to podívám a poradím, jak na to nejlépe jít.
Jak se generuje tato komplexní sada vah modelu, jejichž hodnoty kódují velkou část lidského vědění? Děje se tak procesem nazývaným „předtrénování“. Cílem je vytvořit model, který dokáže předpovědět další token pro všechna slova, která jsou dostupná na internetu. Během předtrénování jsou váhy postupně aktualizovány pomocí metody matematické optimalizace zvané gradientní sestup. Můžeme si to představit jako turistu v husté mlze na hoře, který se snaží dostat dolů. Protože nevidí celou horu, může zhodnotit pouze strmost svahu v bezprostředním okolí a vydá se směrem nejprudšího klesání. Model postupně "měří" strmost a učí se, jak upravit své váhy, aby minimalizoval chybu v předpovědi.
Jakmile máme hotový model, můžeme na něm spustit „inference“, což je proces, kdy modelu předložíme textový dotaz. Například dotaz může znít: „napiš krátký blogový příspěvek o výhodách agilního vývoje“. Model poté předpovídá nejpravděpodobnější další token (slovo). Tuto předpověď provádí na základě minulého vstupu a dosud vygenerovaného textu, a opakuje se to token po tokenu, slovo po slovu, dokud nevygeneruje celou odpověď.
Fungování těchto modelů není žádná magie a stojí za to mu porozumět. První reakce na interakci s těmito systémy bývá často pocit, že jde o něco kouzelného. Dokáží generovat odpovědi, které působí, jako by pocházely od člověka, a mají přístup k obrovskému množství informací. Je důležité si uvědomit, že velké jazykové modely „nemyslí“ ani „nerozumí“ jako lidé. Místo toho generují slova na základě statistické pravděpodobnosti toho, jaké slovo by mělo následovat, s ohledem na vstup a vše, co bylo dosud vygenerováno.
Základní princip je poměrně jednoduchý: začít s obrovským vzorkem lidského textu (z webu, knih atd.) a poté natrénovat neuronovou síť tak, aby generovala text, který je „podobný tomuto vzorku“. A konkrétně, aby dokázala začít od „promptu“ a pokračovat textem, který je „podobný tomu, na čem byla natrénována“. Ačkoli je skutečná neuronová síť složena z miliard velmi jednoduchých prvků a její základní operace je také velmi prostá – v podstatě spočívá v průchodu vstupu odvozeného z dosud vygenerovaného textu „jednou přes její prvky“ pro každé nové slovo (nebo část slova) –, pozoruhodné a neočekávané je, že tento proces dokáže produkovat text, který je úspěšně „podobný“ tomu, co je k dispozici na webu a v knihách. I když modely „pouze“ vybírají „koherentní vlákno textu“ ze „statistik konvenční moudrosti“, kterou nashromáždily, výsledky jsou úžasně lidské.