
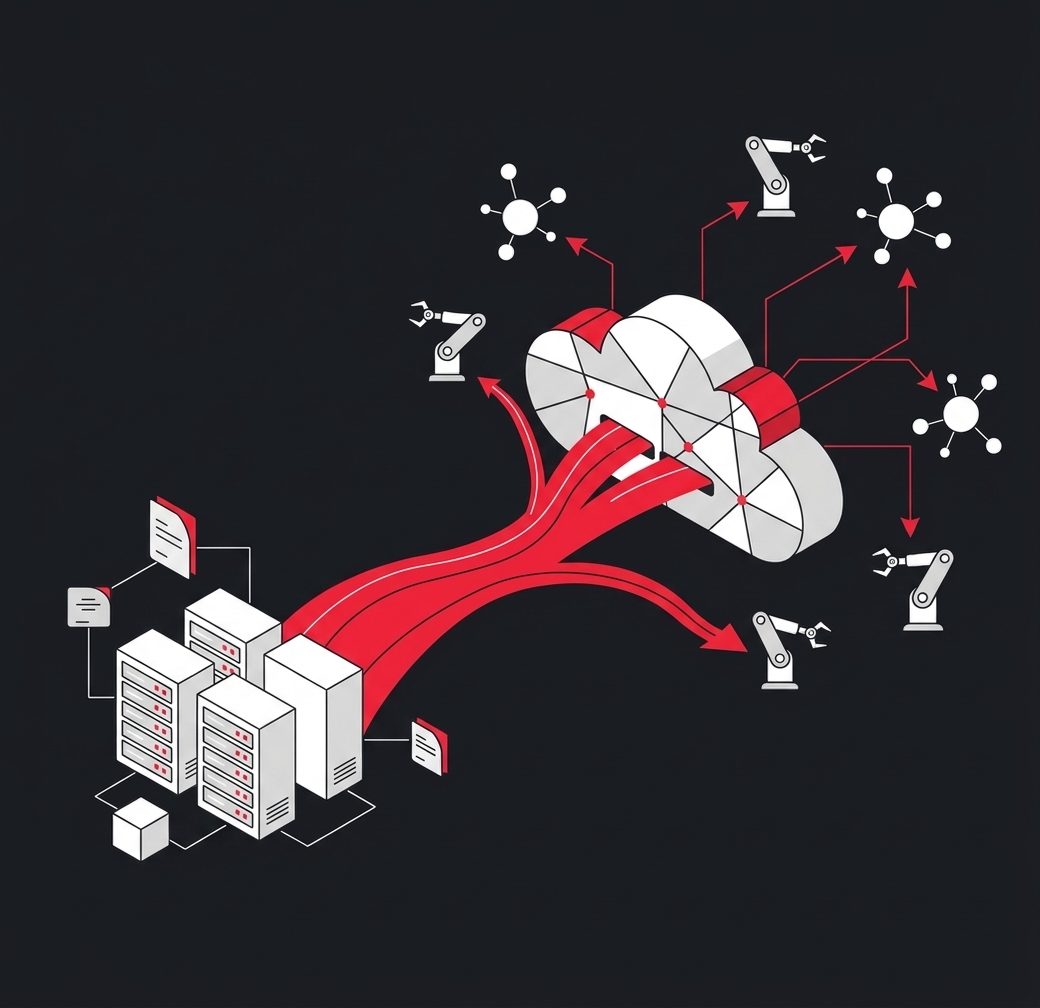
Překotný růst provozu v systémech pro správu verzí, jako je Git, v posledním roce vedl k zásadní transformaci. Většina datových úložišť se přesunula z původních datových center do cloudové infrastruktury, konkrétně do prostředí Azure. Nicméně, zbývající nejvytíženější repozitáře stále čelily výzvám způsobeným latencí sítě.
Základem nové generace architektury úložišť jsou dva klíčové principy: minimalizace koordinace mezi komponentami a oddělení úložišť od výpočetních prostředků. Tyto principy tvoří páteř pro budoucí vývoj.
Následující text se zaměří na přechodovou fázi mezi starým a novým designem. Prozkoumáme, jak úprava způsobu serializace zápisů v rámci kvora umožňuje přesunout i ty nejvytíženější repozitáře do cloudového prostředí a zároveň otevírá cestu pro repliky, které si neudržují vlastní perzistentní stav.
K tomuto kroku došlo v důsledku několika faktorů, primárně pak vlivem masivního nárůstu automatizovaného provozu (tzv. "agentic shift"), dosažení hranic energetické kapacity stávajících datových center a omezení dodavatelských řetězců. Změna architektury úložišť a hostingové platformy současně by za těchto podmínek představovala příliš velké riziko. Vzhledem k rozsahu platformy a její kritické důležitosti pro komunitu bylo nutné pečlivě naplánovat posloupnost prací: nejprve přesunout data, a teprve poté vyvíjet architekturu.
Operace s Git repozitáři jsou klasifikovány jako služba "Tier 0", což znamená, že představují klíčovou funkci a téměř vše na platformě na nich závisí. To si vyžádalo přesun dat, služeb a všech závislostí jako první. První kopie repozitáře přistála v datovém centru cloudového poskytovatele v centrální oblasti USA v srpnu 2025 (podle původního zdroje). Dnes má většina repozitářů dvě z pěti replik v cloudovém prostředí a cloud obsluhuje přibližně polovinu celkového Git provozu. Během většiny tohoto období cloud absorboval veškerý růst, zatímco původní datová centra udržovala stabilní zatížení.
Během migrace se provoz řídí dostupností dat. Většina repozitářů má pět replik pro vyvážení odolnosti, dostupnosti a škálovatelnosti. Pro minimalizaci latence čtení se používá preferenční směrování, které směřuje provoz na repliku ve stejné oblasti a zóně dostupnosti jako požadavek. S přesunem replik do cloudu se podíl provozu obsluhovaného z cloudového prostředí zvyšuje, dokud se nepřesune poslední replika a původní region přestane přijímat požadavky.
Co však s oním zbývajícím zlomkem procenta nejvytíženějších repozitářů? V původní architektuře má repozitář hostovaný ve více regionech nižší strop propustnosti pro zápisy. Kvorum sice potřebuje většinu k potvrzení zápisu, ale čeká na odpověď od každé zdravé repliky (až do vypršení časového limitu), než se posune dál. To znamená, že pomalé repliky zdržují každý zápis namísto toho, aby se zpožďovaly. V praxi tak nejpomalejší zdravá replika určuje latenci každého zápisu. A protože každý zápis drží celorepozitářový zámek, ovlivňuje i celkovou propustnost. Jakmile replika sídlí v cílové cloudové oblasti, je vzdálena přibližně 1 600 kilometrů od původních datových center, což znamená, že každá síťová odezva trvá kolem 25 ms a zápis vyžaduje více těchto odezev. Repozitář, který se již blíží svému limitu propustnosti, by takovou zátěž nemohl při každém serializovaném zápisu absorbovat a s každým odesláním by se propadala výkonnost.
Zde přichází na řadu první architektonický princip: minimalizace koordinace. Konkrétně v tomto případě jde o to, neserializovat to, co serializovat nepotřebujeme. Konzistenční požadavky Gitu se vztahují na každou referenci individuálně. Jakmile server přijme aktualizaci reference, žádný klient by již neměl vidět starší hodnotu, pouze tu aktuální nebo novější. To platí bez ohledu na to, zda jde o fast-forward, force push nebo smazání. Ve většině případů však aktualizace různých referencí na sobě nezávisí a mohou být aplikovány nezávisle.
Proto se rozsah kvora mění z celého repozitáře na jednotlivé reference. Držet celorepozitářový zámek po celou dobu aktualizace reference, včetně síťových odezev, mění kvorum v jedinou, neuspořádanou frontu požadavků s jedním zápisem v běhu. Každý zápis v této frontě trvá tak dlouho, jako nejpomalejší zdravá replika. S rostoucí rychlostí zápisu roste i fronta a každý zápis čeká déle než ten předchozí.
Při serializaci na úrovni jednotlivých referencí na sebe musí čekat pouze zápisy, které si konkurují na sdílenou referenci. V praxi většina zápisů do repozitáře ovlivňuje různé reference – například automatizovaní agenti a vývojáři pushují do vlastních větví – takže na sebe již nečekají. Každý zápis sice stále zažívá meziregionální latenci, ale zápisy do různých referencí mohou probíhat souběžně. Tím se odstraní jediné úzké hrdlo na úrovni repozitáře. Tyto změny zvyšují strop propustnosti zápisu repozitáře zhruba úměrně počtu souběžně zapisovaných referencí a umožňují přesunout poslední zbývající repozitáře do cloudového prostředí. V interním testování s realistickým provozem vykazovaly zápisy do různých referencí konzistentně 3–4x vyšší propustnost při nižší latenci.
Většina repozitářů je silně orientovaná na čtení, s poměrem čtení k zápisům mezi 100 a 1 000 ku 1. V současné době čtení i zápisy zatěžují stejné repliky, takže si konkurují o stejné zdroje a nelze je škálovat nezávisle.
Oddělení úložiště od výpočetních prostředků to mění. Jakmile jsou data repozitáře trvale uložena v objektovém úložišti cloudového poskytovatele a aktualizována s každým příchozím zápisem, můžeme začít oddělovat provoz čtení od kvora zápisu a nezávisle škálovat výpočetní výkon potřebný pro každou operaci. Například čtení by profitovalo z mnohem větší in-memory cache, než je jim přiděleno dnes, ale tato paměť je zároveň potřebná pro komprimaci (compaction). Jakmile jsou tyto procesy odděleny, každý z nich získá vlastní konfiguraci.
Prvním krokem je začlenění objektového úložiště jako člena kvora, ovšem jako speciální "virtuální repliky". Výpočetní prostředky, které ji reprezentují, jsou prvním plně efemérním uzlem. Slouží jako most k objektovému úložišti, streamuje příchozí zápisy a neobsluhuje žádná čtení. Jelikož je členem kvora, zápis není potvrzen, dokud není trvale uložen v objektovém úložišti.
To sice přidává trochu latence ke každému zápisu, ale stejně jako u meziregionální síťové odezvy, serializace na úrovni referencí zabraňuje tomu, aby se stala úzkým hrdlem propustnosti. Virtuální replika pro zápis také sjednocuje transakce na nesouvisejících referencích do jedné sady síťových I/O operací do objektového úložiště, takže vytížený repozitář platí za jednu síťovou odezvu napříč mnoha souběžnými zápisy namísto jedné za každý zápis. Prozatím virtuální replika pro zápis také zpracovává komprimaci a repliky pro čtení dědí zkomprimovaný stav.
Chystáte nový web nebo aplikaci?
Napište mi, co plánujete — rád se na to podívám a poradím, jak na to nejlépe jít.
S virtuální replikou pro zápis na místě můžeme na vyžádání škálovat libovolný počet virtuálních replik pro čtení. Každá replika pro čtení zahřeje svou cache z objektového úložiště cloudového poskytovatele a začne přijímat provoz čtení, aniž by se připojila ke kvoru, používajíc objektové úložiště jako zdroj pravdy a v pozadí s ním slaďuje svůj lokální stav. Tento krok odemyká významné škálování čtení. V interním testování dosáhla distribuovaná zátěžová testovací sada limitů současné architektury. Proti virtuálním replikám pro čtení však narazila nejprve na vlastní limity.
Přináší to však i několik výzev, které se řeší v následujících krocích: Virtuální repliky pro čtení začínají slaďováním s objektovým úložištěm na pozadí, což je činí vhodnými pro některé pracovní zátěže čtení, ale ne pro všechny. Obsluhování všech typů čtení vyžaduje přesun tohoto slaďování do inline režimu, kdy se načítá pouze stav reference a data, která se změnila od posledního synchronizace repliky. I když jsme postupně zvýšili propustnost zápisu přechodem na model na úrovni referencí, kvorum zůstává omezujícím faktorem pro další zvyšování.
Platforma, jak ji známe dnes, byla postavena na kvóru Spokes, a ten se v průběhu let stal mnohem více než jen koordinátorem kvora. Je to také inteligentní vrstva pro směrování a vyvažování zátěže, jednotné API, které interní klienti používají pro přístup a transakce s daty repozitářů, s více než 100 miliardami operací denně, a soubor systémů na pozadí, které se starají o umístění repozitářů, opravy a vyvažování mezi uzly úložiště.
Naprostá většina toho, co spadá pod službu Spokes, se hodí stejně dobře pro novou architekturu jako pro stávající. Nicméně si také uvědomujeme, že současný protokol pro commit, který platformu dovedl k miliardě repozitářů, ji již nedovede k další miliardě a dál.
Práce není ještě u konce. S těmito kroky je dalším limitem propustnost zápisu. Každý zápis stále čeká na repliky, které každá drží plnou kopii repozitáře, přestože jen velmi malá část zápisu skutečně potřebuje být uspořádaná. Git objekty jsou neměnné a pojmenované podle svého obsahu, takže mohou být uloženy bez nutnosti shody. Zbytek je malý, a těžké je ho uspořádat co nejrychleji, aniž by se úzké hrdlo přesunulo jinam. Navrhovat to na bílé tabuli je jedna věc. Dělat to pod miliardou repozitářů, do kterých vývojáři a automatizovaní agenti neustále zapisují, je věc druhá. Dosažení tohoto stavu nás přinutilo přehodnotit i sekundární efekty, jako je umístění trvalého stavu referencí a škálování komprimace a garbage collection.
Provoz generovaný automatizovanými agenty se nezpomaluje a každý z těchto kroků poskytuje repozitářům větší rezervu, aniž by se čekalo na konečný stav.
Příští týden se zaměříme na konečný stav, co přinese pro propustnost zápisu, sekundární problémy, které bylo třeba vyřešit k dosažení tohoto stavu, a proč stále existuje (malá) konsenzuální skupina někde ve stacku.